Velikost modelu vám o jeho rychlosti neřekne skoro nic. 35B model umí na jednom NVIDIA GB10 běžet 22× rychleji než 128B model na té samé krabici - záleží na počtu aktivních parametrů, ne na celkovém. A pro český RAG vám bohatě stačí multilingvální embedder velký 1,3 GB; anglicky orientované modely na češtině padají. Tohle nejsou dojmy z marketingu - všechno níž je změřené na jednom boxu, reprodukovatelné, se skripty na GitHubu.
Klienti se mě pořád ptají na jednu věc: „Co reálně rozjedeme u sebe, bez cloudu?" Místo odpovědi od oka jsem si půjčil hardware a 48 hodin měřil. Tady jsou čísla.
Co je NVIDIA GB10 a proč o něm psát Link to heading
GB10 (Grace Blackwell) je čip, na kterém staví NVIDIA DGX Spark - kompaktní desktopový „AI superpočítač" se 128 GB unified pamětí (sdílí ji CPU i GPU), 20jádrovým ARM CPU a výkonem kolem 1 PFLOP ve FP4. Do téhle paměti se vejdou modely až do ~200 miliard parametrů (ve FP4), a to celé na jedné krabici velikosti knihy, bez datacentra a bez jediného tokenu odeslaného do cloudu. Stejnou silikonovou platformu prodává řada výrobců - Dell, HP, ASUS, Lenovo a další; cena se dnes pohybuje kolem 4 700 USD a s růstem cen pamětí spíš stoupla.
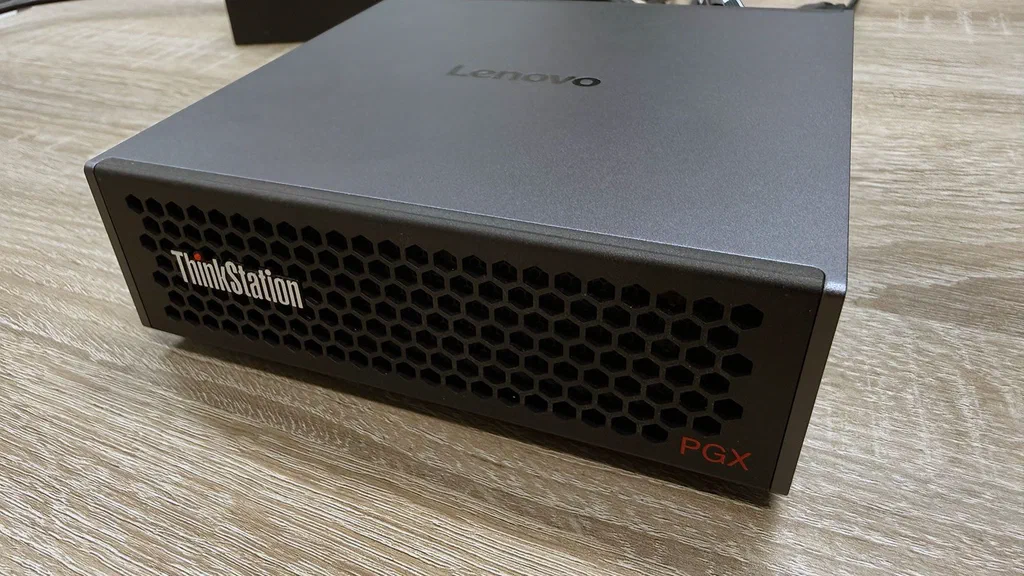
Měřil jsem na Lenovo ThinkStation PGX (tedy GB10), který mi na 48 hodin zapůjčil distributor SWS. Konkrétní sestava: Ubuntu (kernel 6.17, aarch64), driver 580 / CUDA 13, runtime Ollama 0.24 s Flash Attention a KV cache f16. Všechna čísla platí pro výchozí Ollama kvantizace (Q4_K_M / MXFP4), ne pro plnou přesnost - což je ostatně přesně to, co se na takové krabici reálně provozuje.
Pro českou malou a střední firmu je to relevantní jednoduše proto, že tahle třída hardwaru poprvé dělá lokální provoz slušných modelů prakticky dosažitelným - otázka už není „jde to vůbec", ale „co konkrétně a jak rychle". Na to odpovídám.
Rozhoduje velikost modelu, nebo počet aktivních parametrů? Link to heading
Aktivní parametry, ne celková velikost. MoE model (mixture-of-experts) aktivuje při každém tokenu jen zlomek vah, takže 35B model se 3B aktivními jede rychleji než leckterý 24B dense model - a 120B MoE překoná 24B dense. Pokud si vybíráte podle čísla v názvu, vybíráte špatně.
Dekódovací rychlost při krátkém promptu (0,5k tokenů, reasoning vypnutý):
| Model | Typ | Dekódování (tok/s) |
|---|---|---|
| Qwen 3.6 35B-A3B | MoE (3B aktivní) | 60,2 |
| gpt-oss 20B | MoE | 58,8 |
| Gemma 4 E4B | edge | 56,6 |
| Llama 3.1 8B | dense | 42,7 |
| gpt-oss 120B | MoE | 42,3 |
| Nemotron 3 Super 120B-A12B | MoE (12B aktivní) | 20,6 |
| Mistral Small 3.2 24B | dense | 13,9 |
| Qwen 3.6 27B | dense | 11,5 |
| Gemma 4 31B | dense | 10,3 |
| Llama 3.3 70B | dense | 4,9 |
| Mistral Medium 3.5 128B | dense | 2,7 |
Mezi nejrychlejším (35B MoE, 60,2 tok/s) a nejpomalejším (128B dense, 2,7 tok/s) je rozdíl zhruba 22×. A přitom 120B MoE od OpenAI (gpt-oss) běží na 42,3 tok/s - tedy 3× rychleji než dense model s poloviční „velikostí". Praktický závěr: pro produkční rychlost na jednom GB10 sahejte po MoE modelech. Dense modely nad ~30B jsou na téhle krabici použitelné spíš na dávkové úlohy, kde na pár tokenech za vteřinu nezáleží.
Co se stane, když modelu dáte dlouhý kontext (celou smlouvu)? Link to heading
Dense modely se na dlouhém kontextu zhroutí, MoE drží. Reálná RAG/agentní úloha (32k tokenů ≈ celá smlouva nebo spis) ještě zvládnou všechny modely v řádu vteřin až pár minut. Na 128k tokenech ale dense modely explodují - a hlavně, KV cache jim sežere paměť tak, že se nevejdou.
Čas do prvního tokenu (TTFT = jak dlouho model „čte", než začne odpovídat) a paměťová stopa, 32k vs. 128k:
| Model | Typ | TTFT @32k | TTFT @128k | Paměť @32k | Paměť @128k |
|---|---|---|---|---|---|
| Mistral Medium 3.5 128B | dense | 145 s | 13 min | 94 GB | 122 GB |
| Llama 3.3 70B | dense | 81 s | 7,6 min | 57 GB | 102 GB |
| Gemma 4 31B | dense | 40 s | 195 s | 28 GB | 36 GB |
| Qwen 3.6 27B | dense | 40 s | 175 s | 25 GB | 32 GB |
| Nemotron 3 Super 120B | MoE | 43 s | 169 s | 92 GB | 93 GB |
| gpt-oss 120B | MoE | 19 s | 92 s | 67 GB | 71 GB |
| Qwen 3.6 35B-A3B | MoE | 17 s | 75 s | 27 GB | 30 GB |
| Llama 3.1 8B | dense | 9 s | 64 s | 11 GB | 31 GB |
| gpt-oss 20B | MoE | 8 s | 43 s | 15 GB | 18 GB |
| Gemma 4 E4B | edge | 6 s | 31 s | 11 GB | 13 GB |
Dvě věci stojí za pozornost. Za prvé: KV cache je skutečný paměťový náklad, ne váhy modelu. Llama 70B vyroste z 43 GB při chatu na 102 GB při 128k kontextu; dense 128B na 128k zabere 122 GB - tedy skoro celou 128GB krabici, a při 256k spadne na OOM. Za druhé: MoE drží paměť i rychlost napříč kontextem (Nemotron 92 → 93 GB), zatímco dense KV cache nafukuje. Pokud plánujete cpát do modelu dlouhé dokumenty, je volba MoE + hlídání délky kontextu důležitější než výběr „chytřejšího" modelu.
(Pozn.: TTFT je reálný prefill - cachování promptu jsem v měření záměrně rozbil, viz metodika. Bez toho runtime hlásí nesmyslné statisíce tok/s.)
Zpomaluje „reasoning" model? Link to heading
Ne. Reasoning negeneruje pomaleji, generuje víc. Dekódovací rychlost je s reasoningem zapnutým i vypnutým stejná - jen čekáte na delší výstup, ne na pomalejší. U Qwenu, Gemmy a Nemotronu vyskočil počet výstupních tokenů 8-40× (Qwen 35B-A3B na 128k: 26 → 1021 tokenů na tutéž úlohu). Na čistě vyhledávací úloze to přidalo latenci bez přínosu pro přesnost - ty modely dávaly plný počet bodů i bez něj.
Dvě praktické pasti, na které jsem narazil a které stojí za zapamatování:
- U gpt-oss je
think: true/falsev Ollamě no-op. gpt-oss řídí reasoning řetězcovou úrovní úsilí (low/medium/high), boolean ignoruje. Když to nevíte, měříte „reasoning on/off", který se vůbec nemění. - Hrubé string-grádery podhodnocují modely za formátování, ne za schopnost. Můj první needle-test ukázal u gpt-oss 1/3 - ukázalo se, že to byl artefakt hodnocení: gpt-oss formátuje odpovědi typografickými pomlčkami a Markdownem, takže striktní shoda chytla jen číselnou jehlu. Po normalizaci je to 3/3 na každém kontextu a každé úrovni úsilí. Model retrieval zvládal celou dobu; chyboval můj grader.
Jaký embedding model zvládne český RAG? Link to heading
Multilingvální modely češtinu zvládají, anglicky orientované na ní padají - a velký model k tomu nepotřebujete. Pro retrieval (vyhledání správné pasáže pro RAG) jsem testoval 10 embedderů na malém českém korpusu. Vítězí multilingvální modely, a malé (~1,3 GB) jsou na úrovni 12× většího.
Kvalita retrievalu na českém korpusu (16 pasáží, 12 parafrázových dotazů - sémantická shoda, ne shoda klíčových slov):
| Model | Typ | recall@1 | MRR | Velikost |
|---|---|---|---|---|
| Snowflake Arctic Embed 2 | multilingvální | 1,00 | 1,00 | 1,3 GB |
| Qwen3-Embedding 8B | multilingvální | 1,00 | 1,00 | 15,4 GB |
| BGE-M3 | multilingvální (hybrid) | 0,92 | 0,96 | 1,3 GB |
| Multilingual E5 Large Instruct | multilingvální | 0,92 | 0,96 | 1,1 GB |
| Qwen3-Embedding 4B | multilingvální | 0,83 | 0,92 | 13,0 GB |
| Qwen3-Embedding 0.6B | multilingvální | 0,83 | 0,89 | 6,3 GB |
| EmbeddingGemma 300M | multilingvální | 0,67 | 0,80 | 1,1 GB |
| Nomic Embed Text | anglicky orientovaný | 0,25 | 0,46 | 0,6 GB |
| all-MiniLM | anglický baseline | 0,08 | 0,26 | 0,1 GB |
| mxbai Embed Large | anglicky orientovaný | 0,08 | 0,24 | 0,8 GB |
Snowflake Arctic Embed 2 a BGE-M3 (oba ~1,3 GB) drží krok s 15,4GB Qwenem3-8B - nemá smysl platit 12× tolik paměti. Naopak anglicky orientované modely (Nomic, mxbai, MiniLM) se na češtině hroutí na recall pod 0,25. Pokud stavíte české RAG, začněte u malého multilingválního embedderu a paměť ušetřete na samotný LLM.
Poctivá výhrada: 12 dotazů je malý vzorek, rozdíl 1,00 vs. 0,92 je jediný dotaz. Čtěte to jako „několik multilingválních embedderů na češtině funguje dobře", ne jako přesné pořadí. Pro produkci validujte na větší české sadě a přidejte reranker.
Co z toho plyne pro českou firmu Link to heading
Když to složím dohromady, realita lokálního provozu na jedné krabici vypadá takhle:
- Reálné pásmo je 7-120B. Díky MoE běží i ~120B model produkční rychlostí na jednom GB10. Není to hranice nejtěžších agentních úloh, ale na rutinu a na práci s citlivými daty to bohatě stačí.
- Pro rychlost vybírejte MoE, ne podle celkové velikosti. Mezi dense a MoE je na téhle krabici i 20× rozdíl v rychlosti.
- Délku kontextu hlídejte jako paměťový rozpočet. KV cache, ne váhy, rozhoduje, jestli se vám dlouhý dokument vejde.
- Na český RAG stačí malý multilingvální embedder.
A z toho plyne i ta nejčastější architektonická odpověď, kterou klientům dávám: hybridní routing. Citlivá a rutinní práce běží lokálně na vlastním železe, nejtěžší reasoning se posílá do frontier modelu - vědomě, podle třídy dat, s auditním logem. Ne „všechno do cloudu", ani „nic do cloudu". To je dnes poctivá architektura, a měřená data jako tahle jsou důvod, proč se dá postavit na číslech místo na slibech.
Tohle je mimochodem přesně to, co dělám: nasazuju a provozuju lokální a hybridní AI pro české a evropské firmy - na infrastruktuře, kterou vlastní ony, ne já. Benchmark vznikl proto, že klienti chtějí měřené odpovědi, ne marketing.
Jak to bylo měřeno Link to heading
Aby čísla něco znamenala, drží se měření několika zásad:
- Cachování promptu je rozbité. Každé měření dostává unikátní prefix (nonce), takže runtime nemůže recyklovat KV cache. Bez toho hlásí nesmyslné rychlosti prefillu a sub-vteřinový TTFT na 80k promptech. Všechna TTFT čísla jsou reálný prefill.
- Flash Attention zapnutý, KV cache f16,
temperature=0,seed=42. Hodnoty jsou mediány opakovaných běhů u krátkých kontextů, jednotlivé běhy u dlouhých (metriky jsou stabilní, dlouhé běhy drahé).num_predict512 bez reasoningu, 2048 s reasoningem. - Reasoning ve výchozím stavu vypnutý, aby byly TTFT a dekódování srovnatelné napříč modely;
--thinkspouští nativní reasoning každého modelu. - Paměť je stopa modelu z
ollama ps- na GB10 jde o unified paměť, ne oddělenou VRAM. - Skripty jsou jen standardní knihovna (na testovací krabici žádné
pip install).
Celé to je v repu, ať si to každý přeměří sám: github.com/OscarActual/gb10-llm-benchmark (licence MIT). Plné tabulky po kontextech jsou ve složce results/.
Limity Link to heading
Aby bylo jasné, co tahle data neříkají:
mistral-medium-3.5:128b(dense, 128B) spadl na OOM při 256k na 128GB krabici - reportováno jen do 128k.- Výsledky platí pro výchozí Ollama kvantizace (Q4_K_M, MXFP4) na jednom GB10. Jiné kvantizace, runtimy (vLLM, TensorRT-LLM) a multi-GPU sestavy se budou lišit.
- Needle a embedding sady jsou malé - odpovídají na „funguje to" a „jaký je zhruba pořádek", ne na jemnou přesnost.
- Štítky délky kontextu (8k/32k/…) jsou nominální cíle; přesný počet tokenů je zaznamenaný v CSV u každého řádku.
Časté otázky Link to heading
Co reálně utáhne jeden NVIDIA GB10? Open-weight modely v pásmu zhruba 7-120B. Díky 128 GB unified paměti a MoE architektuře běží produkční rychlostí i ~120B model; nejtěžší dense modely (128B) jsou použitelné spíš dávkově a na dlouhém kontextu narážejí na paměť.
Je lepší velký dense model, nebo MoE? Na rychlost MoE - aktivuje při tokenu jen zlomek vah. Na jednom GB10 dává 35B MoE přes 60 tok/s, zatímco 128B dense jen 2,7 tok/s. MoE navíc drží rychlost i paměť i na dlouhém kontextu.
Jaký embedding model na český RAG? Multilingvální. Snowflake Arctic Embed 2 nebo BGE-M3 (oba ~1,3 GB) dávají na češtině recall@1 nad 0,9 a vyrovnají se 15GB modelu. Anglicky orientované modely (Nomic, mxbai, MiniLM) na češtině selhávají.
Zpomaluje reasoning generování? Ne - dekódovací rychlost je stejná, model jen vygeneruje víc tokenů (i 8-40×), takže celkově čekáte déle. Pozor: u gpt-oss se reasoning řídí řetězcem low/medium/high, ne booleanem.
Stačí jeden box pro firmu? Na rutinní a citlivou práci s lokálními modely často ano. Na nejtěžší reasoning se vyplatí hybridní routing do frontier modelu - vědomě, podle třídy dat, s auditem.
Autor: František Břicháček - 30 let v IT a bezpečnosti, 3× dodané prostředí ISO 27001. V Alpha Solutions nasazuju a provozuju suverénní a hybridní AI pro české a evropské firmy na infrastruktuře, kterou vlastní ony. Co doporučuju, sám provozuju. Repo k tomuto článku: github.com/OscarActual/gb10-llm-benchmark.